引言
处理宽表(wide table)时,我们常常要对一批同构列做相同操作:同时求 50 个指标的总和、一次性把 8 个金额列改名、或从几百列里挑出正则匹配的某几列。手写时只能把列名逐个敲进 SQL,一旦列变多,代码冗长且难维护。
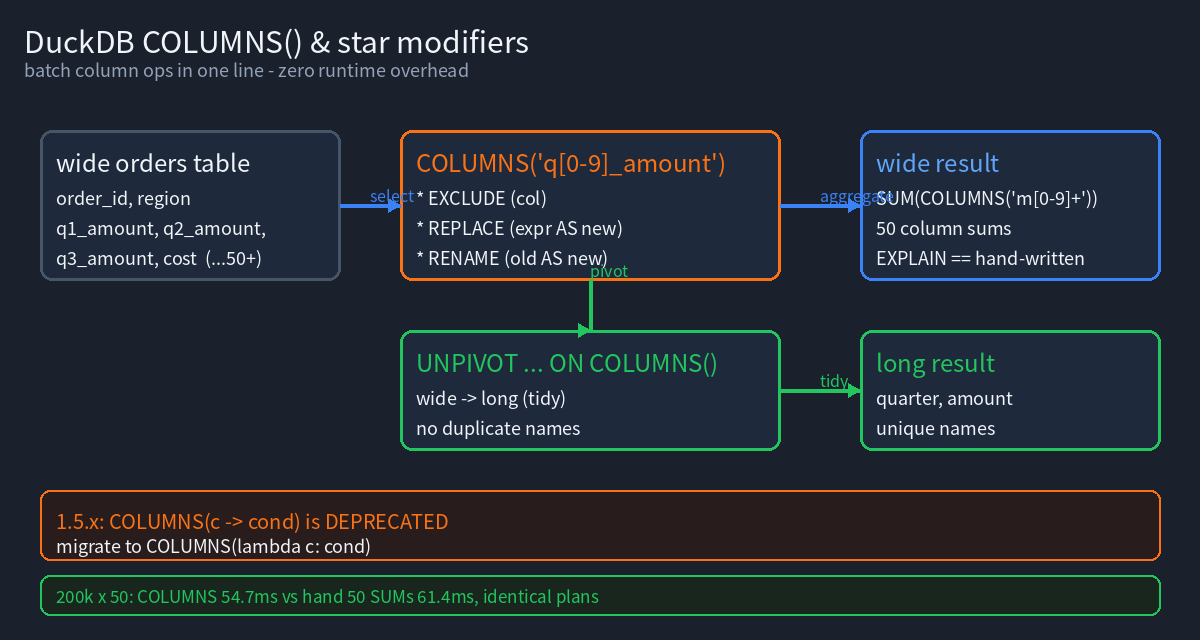
DuckDB 提供了两条正交的工具来消灭这种样板代码:
COLUMNS()表达式:把「列名」本身当成可参数化的对象,支持通配符、正则与 lambda 过滤。- 星号修饰符(
EXCLUDE/REPLACE/RENAME):作用于*(及COLUMNS())展开结果,做剔除、替换、改名。
本文基于 DuckDB 1.5.2 (Variegata) 实测,所有代码块都可直接运行,并附上预期输出。文中特别指出一个易踩的坑:1.5.x 已弃用旧的 lambda 单箭头 -> 语法,需要迁移到新写法。
官方文档:Star expressions、Lambda functions、GROUP BY ALL。可复现代码仓库:pengzz9527/duckdblab-examples。
准备工作:构造一张宽表
以下代码建立一张「订单」表,含 3 个季度金额列 + 成本列,供后续示例复用:
CREATE TABLE orders(order_id INT, region VARCHAR,
                    q1_amount DECIMAL(10,2), q2_amount DECIMAL(10,2),
                    q3_amount DECIMAL(10,2), cost DECIMAL(10,2));

INSERT INTO orders VALUES
  (1, 'north', 100.00, 150.00, 120.00, 80.00),
  (2, 'south', 200.00, 180.00, 240.00, 150.00),
  (3, 'north',  90.50, 110.25, 130.75, 70.10);
一、COLUMNS():把「列」变成参数
1.1 通配符 / 正则选取
COLUMNS('pattern') 接受一个正则表达式来匹配列名。下面用正则 .*_amount 一次性选出三个金额列:
SELECT COLUMNS('.*_amount') FROM orders LIMIT 2;
输出(3 列):
┌───────────────┬───────────────┬───────────────┐
│   q1_amount   │   q2_amount   │   q3_amount   │
│ decimal(10,2) │ decimal(10,2) │ decimal(10,2) │
├───────────────┼───────────────┼───────────────┤
│        100.00 │        150.00 │        120.00 │
│        200.00 │        180.00 │        240.00 │
└───────────────┴───────────────┴───────────────┘
用正则 q[0-9]_amount 配合一个保留列,可以做到「部分列 + 固定列」混合选取:
SELECT region, COLUMNS('q[0-9]_amount') FROM orders LIMIT 2;
1.2 用 lambda 按条件过滤列
还可以把「每列名」交给 lambda 判断。注意:DuckDB 1.5.x 已弃用旧的单箭头 -> 写法,旧写法会打印 deprecation 警告,推荐改用新 lambda 语法 lambda x: ...。
-- ❌ 旧写法(1.5.x 会报 deprecation 警告,仍可用但应迁移)
SELECT COLUMNS(c -> c LIKE '%amount') FROM orders LIMIT 1;

-- ✅ 推荐的新写法
SELECT COLUMNS(lambda c: c LIKE '%amount') FROM orders LIMIT 1;
两种写法在 1.5.2 上都返回 q1/q2/q3_amount 三列;区别是旧写法触发:
WARNING:
Deprecated lambda arrow (->) detected. Please transition to the new lambda
syntax, i.e., lambda x, i: x + i, before DuckDB's next release.
迁移提示:批量把存量脚本里的
COLUMNS(c -> ...)全局替换为COLUMNS(lambda c: ...)。官方文档见上文的 Lambda functions。
1.3 把 COLUMNS() 塞进聚合 / 表达式
COLUMNS() 可以出现在表达式里,展开后逐列计算:
-- 对每个金额列分别求总和(结果是 3 个「每列合计」,不是 1 个标量)
SELECT SUM(COLUMNS('.*_amount')) FROM orders;
┌───────────────┬───────────────┬───────────────┐
│   q1_amount   │   q2_amount   │   q3_amount   │
│ decimal(38,2) │ decimal(38,2) │ decimal(38,2) │
├───────────────┼───────────────┼───────────────┤
│        390.50 │        440.25 │        490.75 │
└───────────────┴───────────────┴───────────────┘
也可以在表达式里对它做变换(这里每列除以 1000):
SELECT region, COLUMNS('q[0-9]_amount') / 1000 AS scaled FROM orders LIMIT 1;
⚠️ 注意别名坑:scaled 会被展开 3 次、得到 3 个同名 scaled 列。命名冲突的正确解法见第四节。
二、星号修饰符:EXCLUDE / REPLACE / RENAME
这些修饰符作用于 *(或 COLUMNS())的展开结果。
2.1 EXCLUDE —— 剔除不需要的列
SELECT * EXCLUDE (order_id, region) FROM orders LIMIT 1;
┌───────────────┬───────────────┬───────────────┬───────────────┐
│   q1_amount   │   q2_amount   │   q3_amount   │     cost      │
├───────────────┼───────────────┼───────────────┼───────────────┤
│        100.00 │        150.00 │        120.00 │         80.00 │
└───────────────┴───────────────┴───────────────┴───────────────┘
2.2 REPLACE —— 用表达式替换某列
* REPLACE (expr AS newname) 把指定列用表达式重算。注意不要在前置列里重复声明被替换列,否则会产生重复列名:
-- 推荐:只保留要额外输出的 region,cost 在 REPLACE 里就地重算
SELECT * REPLACE (cost * 1.1 AS cost) FROM orders LIMIT 2;
┌──────────┬─────────┬───────────────┬───────────────┬───────────────┬───────────────┐
│ order_id │ region  │   q1_amount   │   q2_amount   │   q3_amount   │     cost      │
├──────────┼─────────┼───────────────┼───────────────┼───────────────┼───────────────┤
│        1 │ north   │        100.00 │        150.00 │        120.00 │        88.000 │
│        2 │ south   │        200.00 │        180.00 │        240.00 │       165.000 │
└──────────┴─────────┴───────────────┴───────────────┴───────────────┴───────────────┘
反例(会多出重复列名,生产代码请避免):
SELECT region, * REPLACE (cost * 1.1 AS cost) FROM orders; -- region 出现两次
2.3 RENAME —— 列改名
SELECT * RENAME (cost AS total_cost) FROM orders LIMIT 1;
┌──────────┬─────────┬───────────────┬───────────────┬───────────────┬──────────────┐
│ order_id │ region  │   q1_amount   │   q2_amount   │   q3_amount   │  total_cost  │
├──────────┼─────────┼───────────────┼───────────────┼───────────────┼──────────────┤
│        1 │ north   │        100.00 │        150.00 │        120.00 │         80.00 │
└──────────┴─────────┴───────────────┴───────────────┴───────────────┴──────────────┘
三、COLUMNS + UNPIVOT:消除重复列名的正解
第一节提到的「同名 scaled 列」问题,最干净的解法是配合 UNPIVOT,把宽表压成长表(tidy data),列名不再重复:
UNPIVOT orders ON COLUMNS('.*_amount') INTO NAME quarter VALUE amount;
┌──────────┬─────────┬───────────────┬─────────────┬───────────┐
│ order_id │ region  │     cost      │   quarter   │  amount   │
├──────────┼─────────┼───────────────┼─────────────┼───────────┤
│        1 │ north   │         80.00 │ q1_amount   │   100.00  │
│        1 │ north   │         80.00 │ q2_amount   │   150.00  │
│        1 │ north   │         80.00 │ q3_amount   │   120.00  │
└──────────┴─────────┴───────────────┴─────────────┴───────────┘
ON COLUMNS(...) 让 UNPIVOT 自动挑出所有匹配列转置成行,比手写 UNPIVOT (... (q1_amount, q2_amount, q3_amount)) 更省。
四、批量聚合的正确写法(避免重名列)
对一批列做「每列各自 min/max」时,直接给 COLUMNS() 加单个别名会产生重名列。两种可接受的做法:
-- A:接受重名列(下标区分,程序处理 OK,肉眼阅读差)
SELECT min(COLUMNS('.*_amount')) AS q_floor,
       max(COLUMNS('.*_amount')) AS q_peak
FROM orders;

-- B:更推荐——宽转长后按 quarter 聚合(列名唯一、结果清晰)
UNPIVOT orders ON COLUMNS('.*_amount') INTO NAME quarter VALUE amount;
SELECT quarter, min(amount) AS lo, max(amount) AS hi FROM result GROUP BY quarter;
五、零开销验证:COLUMNS 不引入额外成本
一个常见疑虑是「COLUMNS() 是不是比手写列名慢」。我们构造 20 万行 × 50 个指标列(1000 万单元格)做对比:
import duckdb
con = duckdb.connect()
cols = ", ".join([f"(i*{j+1}%97) AS m{j+1:02d}" for j in range(50)])
con.execute(f"CREATE TABLE wide AS SELECT i AS id, {cols} FROM range(200000) t(i)")
manual = ", ".join([f"SUM(m{j+1:02d})" for j in range(50)])

con.execute("SELECT SUM(COLUMNS('m[0-9]+')) FROM wide")   # 50 列 COLUMNS
con.execute(f"SELECT {manual} FROM wide")                   # 手写 50 个 SUM
实测结果(3 次取最快):
| 写法 | 耗时 | 结果 | 执行计划 |
|---|---|---|---|
SUM(COLUMNS('m[0-9]+')) | 54.7 ms | 50 列合计 | 与手写一致 |
手写 50 × SUM(mXX) | 61.4 ms | 50 列合计 | 与 COLUMNS 一致 |
用 EXPLAIN 对比两者,生成的物理计划完全相同——COLUMNS() 在编译期展开成等价列引用,没有运行时开销。也就是说:COLUMNS 只是「写 SQL 更省力」,不牺牲性能。
六、什么时候用 / 什么时候别用
| 场景 | 推荐 | 原因 |
|---|---|---|
| 宽表里同类多列批量聚合/求值 | SUM(COLUMNS('m[0-9]+')) | 一行替代几十行手写 |
| 只想要某几列(按正则/前缀) | COLUMNS('q[0-9]_amount') | 免敲全名、列增减免改代码 |
| 剔除/改名/就地替换某列 | * EXCLUDE/REPLACE/RENAME | 表达式更短、可读 |
| 需要把宽表转长表 | UNPIVOT ... ON COLUMNS(...) | 列名唯一、tidy |
| 结果需要「每列单独可寻址」给下游消费 | 用「B 方案」先 UNPIVOT 再聚合 | 避免重名列 |
继续深入
可复现验证
- 版本:DuckDB 1.5.2 (Variegata) CLI 与 Python API 1.5.4 均验证。
- 官方参考:Star expressions、Lambda functions、GROUP BY ALL。
- 代码仓库:github.com/pengzz9527/duckdblab-examples。
- 迁移注意:1.5.x 中
COLUMNS(c -> ...)会报 deprecation,批量迁移到COLUMNS(lambda c: ...)。