引言:“直接采样就行了"只对了一半
“直接采样就行了”——这是面对大表时最常见的建议。听起来很划算:只读 10% 的数据,就该得到快 10 倍的结果。但在 DuckDB 里,这个直觉只对了一半,而错的那一半正是最容易踩坑的地方。
DuckDB 支持两种采样语法:原生的 USING SAMPLE 和 SQL 标准的 TABLESAMPLE;背后则有三种算法:SYSTEM、BERNOULLI、RESERVOIR。它们的行为差别很大,默认值不同,而且其中一种无论你要百分之几,都会悄悄扫完整张表。
下面所有数字都来自 DuckDB 1.5.4,那些反直觉的结论(包括一次采样让查询慢 16 倍)都可以复现。
两种语法,一个容易混淆的重叠
DuckDB 同时接受这两种写法:
-- DuckDB 原生
SELECT * FROM events USING SAMPLE 10%;

-- SQL 标准
SELECT * FROM events TABLESAMPLE 10 PERCENT;
看起来可以互换,其实不能。USING SAMPLE 既接受百分比,也接受行数;而 TABLESAMPLE 把裸数字当百分比,把括号里的数字当成完全不同的东西 —— 这就是第一个陷阱的来源。
先建一张表:
CREATE TABLE events AS
SELECT i AS id,
       (i % 7) AS category,
       random() * 100 AS value
FROM range(100000) t(i);
SELECT count(*) FROM events;
┌──────────────┐
│ count_star() │
│    int64     │
├──────────────┤
│       100000 │
└──────────────┘
三种采样方法,与它们的隐藏默认值
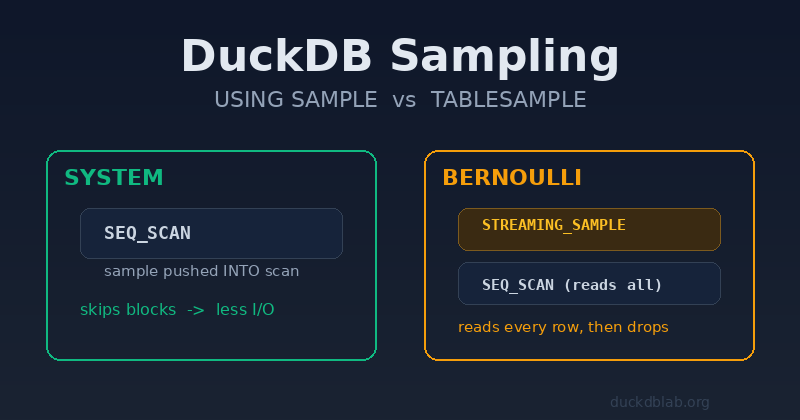
两种语法背后是三种算法。选哪一种,同时决定了结果和代价:
| 方法 | 机制 | 粒度 | 是否读全表 |
|---|---|---|---|
RESERVOIR | 边扫描边维护蓄水池,输出精确大小的均匀样本 | 行 | 是 |
BERNOULLI | 每行独立抛硬币 | 行 | 是 |
SYSTEM | 随机挑选整块 / row group | 块 | 否(可下推) |
两种写法的默认方法并不相同,这一点很容易被忽略:
-- 百分比形式:默认是 SYSTEM
EXPLAIN SELECT count(*) FROM events USING SAMPLE 10% (system);

-- 行数形式:默认是 RESERVOIR
SELECT count(*) FROM events USING SAMPLE 5000 ROWS;
在 10 万行数据上实测,三种方法对同一个"10%“给出的样本量明显不同:
USING SAMPLE 10% (system)     ->  8192 行
USING SAMPLE 10% (bernoulli)  -> 10017 行
USING SAMPLE 10% (reservoir)  -> 10000 行
RESERVOIR 精确;BERNOULLI 统计上准确但有噪声;SYSTEM 按块量化,可能偏离标称比例几个百分点 —— 这不是 bug,而是"能跳过 I/O"必须付出的代价。
五个语法陷阱与真实报错
陷阱一:USING SAMPLE 必须是 FROM 里最后一项
不能直接接 WHERE 或 GROUP BY:
SELECT category, count(*)
FROM events USING SAMPLE 20%
GROUP BY category;
Parser Error: syntax error at or near "GROUP"
把采样包进子查询即可:
SELECT category, count(*)
FROM (SELECT * FROM events USING SAMPLE 20% (bernoulli)) s
GROUP BY category
ORDER BY category;
陷阱二:TABLESAMPLE SYSTEM (n) 非法
括号形式要求的是百分比,小整数会被当成行数并报错:
SELECT count(*) FROM events TABLESAMPLE SYSTEM (5);
Error: Sample method System cannot be used with a discrete sample count,
either switch to reservoir sampling or use a percentage.
应写成 TABLESAMPLE SYSTEM (5%) 或裸写的 TABLESAMPLE 5 PERCENT。BERNOULLI 同理。
陷阱三:TABLESAMPLE RESERVOIR (5) 是 5 行
SELECT count(*) FROM events TABLESAMPLE RESERVOIR (5);
┌──────────────┐
│       5      │
└──────────────┘
是 5 行,不是 5%。RESERVOIR 是唯一在括号形式里接受离散行数的算法。
陷阱四:SYSTEM 可能返回零行
因为 SYSTEM 按整块采样,如果整张表只有一个 row group,就没有块可挑。你要 5%,结果可能一行都没有:
CREATE TABLE small AS SELECT i FROM range(1000) t(i);
SELECT count(*) FROM small USING SAMPLE 5% (system);
┌──────────────┐
│       0      │
└──────────────┘
需要小表也能拿到样本,请用 RESERVOIR。
陷阱五:SYSTEM 与 TABLESAMPLE SYSTEM 底层不同
USING SAMPLE … (system) 会把采样下推进扫描;而 TABLESAMPLE SYSTEM (x%) 可能表现为一个独立算子(见下一节),这会直接影响代价。
EXPLAIN 揭示了什么:下推 vs 事后过滤
这部分解释了后面所有基准结果。对比两个执行计划:
EXPLAIN SELECT count(*) FROM events USING SAMPLE 10% (system);
┌───────────────────────────┐
│    UNGROUPED_AGGREGATE    │
└─────────────┬─────────────┘
┌─────────────┴─────────────┐
│          SEQ_SCAN         │
│       Sample Method:      │
│       System: 10.0%       │   <-- 采样发生在扫描算子内部
└───────────────────────────┘
EXPLAIN SELECT count(*) FROM events USING SAMPLE 10% (bernoulli);
┌───────────────────────────┐
│    UNGROUPED_AGGREGATE    │
└─────────────┬─────────────┘
┌─────────────┴─────────────┐
│      STREAMING_SAMPLE     │   <-- 扫描之上多了一个算子
│   Bernoulli: 10.000000%   │
└─────────────┬─────────────┘
┌─────────────┴─────────────┐
│          SEQ_SCAN         │   <-- 仍然读取每一行
└───────────────────────────┘
两个世界:
SYSTEM把采样下推进扫描算子,扫描知道可以跳过整块,因此能省 I/O。BERNOULLI(和RESERVOIR)在扫描之上加一个算子,扫描仍然碰每一行,算子再把大部分行丢掉。你付了全部 I/O 和物化成本,最后扔掉绝大部分。
这一个事实解释了为什么 BERNOULLI 常常比"不采样"还慢。
让样本可复现
随机采样每次结果都不同。要固定下来 —— 这是可复现实验的前提 —— 传入种子:
SELECT count(*) FROM events USING SAMPLE 5% (reservoir, 7);
┌──────────────┐
│    5000      │
└──────────────┘
同一个种子跑两次得到完全相同的 5000 行;换种子则不同。这是让"采样结果"变成可引用产物的唯一办法。
基准测试:采样什么时候真的更快
以下均为 best-of-3,DuckDB 1.5.4,4 线程,本地 SSD,Parquet + ZSTD。
廉价谓词(500 万行)
数据:5,000,000 行,约 45 MB Parquet。查询:count(*) WHERE value > 900。
| 计划 | 耗时 | 相对全表扫描 |
|---|---|---|
| 全表扫描 | 62.9 ms | 1.00× |
USING SAMPLE 10% (system) | 55.4 ms | 1.14× 更快 |
USING SAMPLE 10% (bernoulli) | 160.9 ms | 0.39×(慢 2.6 倍) |
USING SAMPLE 500000 ROWS (reservoir) | 1008.9 ms | 0.06×(慢 16 倍) |
采样几乎没帮上忙,而且三种方法里有两种明显更慢。RESERVOIR 不仅要扫全表,还要维护一个 50 万行的蓄水池。
昂贵的逐行谓词
同样数据,但过滤条件换成逐行正则(对 email 列做 regexp_matches):
| 计划 | 耗时 | 相对全表扫描 |
|---|---|---|
| 全表扫描 | 1086.0 ms | 1.00× |
USING SAMPLE 10% (system) | 624.5 ms | 1.7× 更快 |
USING SAMPLE 1% (system) | 390.3 ms | 2.8× 更快 |
USING SAMPLE 10% (bernoulli) | 1170.7 ms | 0.93×(更慢) |
结论反转了。当每行处理很贵时,在昂贵操作之前丢掉行就有收益 —— 而功劳属于 SYSTEM,因为它在扫描阶段剪枝,而不是事后过滤。
由此得到一条经验法则: 采样带来的收益,与查询其余部分的昂贵程度成正比。如果查询只是对本地热数据做一个廉价聚合,全表扫描本来就够快,采样只会增加开销。
样本有多准?
只有当估计值可信时,采样才有用。对约 499,441 / 5,000,000 行(约 10%)的谓词,把样本放大后的误差如下:
| 方法 | 样本比例 | 估计总数 | 误差 |
|---|---|---|---|
SYSTEM | 1% | 565,400 | 13.21% |
SYSTEM | 5% | 511,460 | 2.41% |
SYSTEM | 10% | 479,750 | 3.94% |
SYSTEM | 25% | 511,548 | 2.42% |
BERNOULLI | 1% | 516,800 | 3.48% |
BERNOULLI | 10% | 499,280 | 0.03% |
两点:
- 1% 太粗,不足以引用;
SYSTEM的误差达到 13%。 - 采样误差并不单调。这里
SYSTEM10% 反而不如 5% —— 按块量化意味着"比例更大"不保证更接近真值。需要给出数字时,BERNOULLI是更稳定的估计器。
采样 vs 近似聚合函数
到底该用采样,还是用 approx_* 聚合函数?在 500 万行上:
| 方案 | 耗时 | 结果 | 误差 |
|---|---|---|---|
count(DISTINCT id)(精确) | 312.6 ms | 5,000,000 | — |
approx_count_distinct(id) | 139.6 ms | 4,889,466 | 2.21% |
USING SAMPLE 5% (system) 放大 | 81.2 ms | 4,751,360 | 4.97% |
这里采样反而更快,但误差大约翻倍。两者并非谁绝对更优:
approx_*聚合函数单趟扫描、原地替换精确算子,误差有界、可预期。去重计数、分位数、top-k 优先用它。- 采样适合"想要一个真实的行的子集、并在这个子集上跑任意后续查询"的场景 —— 比如测试夹具,或可复现的探索样本。
分位数上差距缩小:同样数据下 quantile_cont 428.6 ms,approx_quantile 308.1 ms —— 1.4× 的收益,而去重计数是 2.2×。
什么时候该采样,什么时候不该
该采样:
- 数据在远端(S3/HTTP)或处于冷缓存,跳过 I/O 本身就是目的。
- 你在探索一张陌生的表,只想要个大概形状,不要精确数字。
- 过滤之后的逐行处理很重(正则、JSON 解析、字符串操作)。
- 你需要一个可复现的实验 —— 用固定种子。
不该采样:
- 全表扫描本来就快(本地热 Parquet、廉价聚合),经常会亏。
- 你需要精确答案,采样给不了。
- 你想用大行数的
RESERVOIR—— 它是最贵的方法。 - 小表需要保证非空样本(
SYSTEM可能返回零行)。
实用配方
可复现的 5% 报告样本:
SELECT category, avg(value)
FROM (SELECT * FROM read_parquet('events.parquet')
      USING SAMPLE 5% (system, 42)) s
GROUP BY category;
精确 N 行的测试夹具:
COPY (SELECT * FROM big_table USING SAMPLE 1000 ROWS (reservoir, 1))
TO 'fixture.parquet' (FORMAT PARQUET);
快速估个分布,再验证:
-- 先快速看一眼
SELECT category, count(*) FROM (SELECT * FROM events USING SAMPLE 5% (bernoulli, 7)) GROUP BY category ORDER BY 2 DESC;
-- 数字重要时,用不带采样的精确答案
SELECT category, count(*) FROM events GROUP BY category ORDER BY 2 DESC;
总结
DuckDB 提供两种语法(USING SAMPLE、TABLESAMPLE)和三种方法(SYSTEM、BERNOULLI、RESERVOIR),默认值与代价各不相同。只有 SYSTEM 能下推进扫描;BERNOULLI 与 RESERVOIR 都会先读完每一行,这正是它们常常比全表扫描更慢的原因。采样不是通用的加速手段 —— 它在昂贵的逐行谓词上取胜(最高 2.8×),在廉价查询上则可能惨败(低至 0.06×)。
下一步建议:
- 对任何采样查询跑一次
EXPLAIN,确认采样位于扫描内部,还是位于其上的STREAMING_SAMPLE算子里 - 只想要近似数字时优先用
approx_*聚合函数;想要"可复跑的行子集"时才用采样 - 打算引用某个样本,就一定要设种子
先测量,再采样。一行 USING SAMPLE 10% 既可能让查询快 3 倍,也可能慢 16 倍 —— 而 EXPLAIN 会在你运行之前就告诉你答案。