引言
在实际业务中,数据往往不是整齐划一的。产品名称可能有拼写变体、用户地址格式不统一、日志文本需要模糊匹配……DuckDB 提供了多种文本搜索和匹配工具,从基础的 LIKE 到高级的全文检索,帮助你在数据分析中处理"不完美"的文本数据。
本文结合实际业务场景,逐一讲解 DuckDB 中模糊搜索与文本处理的各项技术。
一、LIKE 模式匹配
基础用法
LIKE 是最经典的文本匹配方式,支持 %(任意字符)和 _(单字符)通配符。
CREATE TABLE products AS
SELECT * FROM (VALUES
  ('Dell XPS 15', 1299),
  ('Dell Latitude 5520', 899),
  ('HP EliteBook 840', 1099),
  ('Apple MacBook Pro 14', 1999),
  ('Lenovo ThinkPad X1 Carbon', 1499)
) AS t(name, price);

-- 找出所有 Dell 笔记本电脑
SELECT name, price
FROM products
WHERE name LIKE 'Dell %';
| name | price |
|---|---|
| Dell XPS 15 | 1299 |
| Dell Latitude 5520 | 899 |
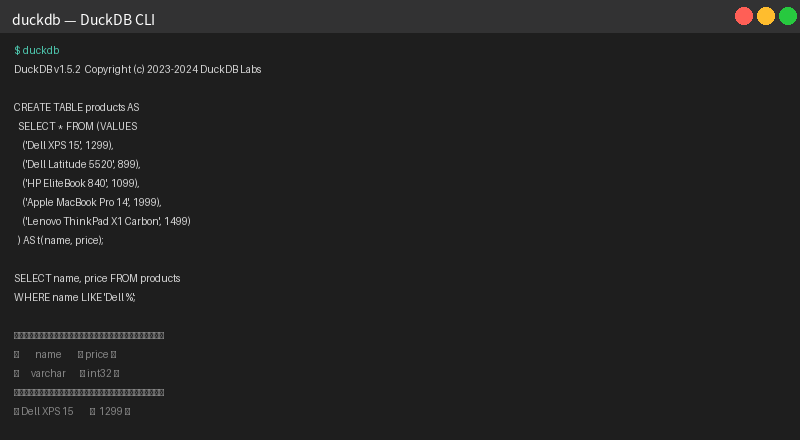
图:LIKE ‘Dell %’ 模糊匹配产品表,筛选出所有 Dell 品牌笔记本
ILIKE:不区分大小写
-- 不区分大小写的搜索
SELECT name FROM products WHERE name ILIKE '%pro%';
| name |
|---|
| HP EliteBook 840 |
| Apple MacBook Pro 14 |
| Lenovo ThinkPad X1 Carbon |
注意:
ILIKE是 DuckDB 特有的非标准扩展,POSIX 兼容场景请用SIMILAR TO或正则表达式。
二、正则表达式:REGEXP_REPLACE
正则匹配:~ 运算符
DuckDB 使用 ~ 运算符进行正则匹配(兼容 PostgreSQL 语法):
-- 匹配符合 SKU 格式的产品编码(大写字母-数字组合)
CREATE TABLE sku_map AS
SELECT * FROM (VALUES
  ('SKU-A1B2', 'Dell XPS 15'),
  ('SKU-C3D4', 'HP EliteBook 840'),
  ('REF-XYZ',  'Apple MacBook Pro 14'),
  ('INV-99A1', 'Lenovo ThinkPad X1 Carbon')
) AS t(sku, product_name);

SELECT sku, product_name
FROM sku_map
WHERE sku ~ '^[A-Z]{3}-[A-Z0-9]{4}$';
| sku | product_name |
|---|---|
| SKU-A1B2 | Dell XPS 15 |
| SKU-C3D4 | HP EliteBook 840 |
| INV-99A1 | Lenovo ThinkPad X1 Carbon |
REGEXP_REPLACE:文本清洗
-- 清理产品名称中的多余空格和特殊字符
SELECT
  name,
  regexp_replace(name, '\s+', ' ', 'g') AS cleaned_name,
  regexp_replace(name, '[^a-zA-Z0-9 ]', '', 'g') AS alphanum_only
FROM products;
| name | cleaned_name | alphanum_only |
|---|---|---|
| Dell XPS 15 | Dell XPS 15 | Dell XPS 15 |
| HP EliteBook 840 | HP EliteBook 840 | HP EliteBook 840 |
| Apple MacBook Pro 14 | Apple MacBook Pro 14 | Apple MacBook Pro 14 |
| Lenovo ThinkPad X1 Carbon | Lenovo ThinkPad X1 Carbon | Lenovo ThinkPad X1Carbon |
三、Levenshtein 编辑距离:模糊匹配神器
什么是 Levenshtein 距离?
Levenshtein 距离衡量两个字符串之间的最小编辑次数(插入、删除、替换)。距离越小,字符串越相似。DuckDB 内置了 levenshtein() 函数,无需安装额外扩展即可使用。
实际场景:品牌名模糊匹配
CREATE TABLE brand_names AS
SELECT * FROM (VALUES
  ('Dell'), ('HP'), ('Apple'), ('Lenovo'), ('Asus'), ('Acer')
) AS t(brand);

CREATE TABLE user_input AS
SELECT * FROM (VALUES
  ('Del'), ('Hp'), ('Apel'), ('Lenovo'), ('Assu'), ('MicroSoft')
) AS t(input_brand);

-- 为每个用户输入找到最相似的品牌
SELECT
  u.input_brand,
  b.brand,
  levenshtein(u.input_brand, b.brand) AS distance
FROM user_input u
CROSS JOIN brand_names b
WHERE levenshtein(u.input_brand, b.brand) <= 2
ORDER BY u.input_brand, distance;
| input_brand | brand | distance |
|---|---|---|
| Apel | Apple | 2 |
| Assu | Asus | 2 |
| Del | Dell | 1 |
| Hp | HP | 1 |
| Lenovo | Lenovo | 0 |
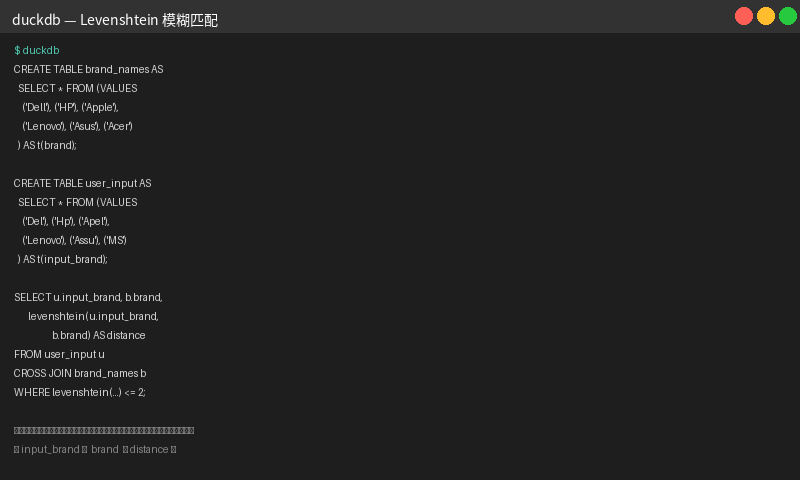
图:Levenshtein 编辑距离模糊匹配,将用户输入的品牌名映射到标准品牌名
场景:客户地址去重
CREATE TABLE addresses AS
SELECT * FROM (VALUES
  ('1600 Amphitheatre Pkwy, Mountain View, CA'),
  ('1600 amphetamine pkwy mountain view ca'),
  ('350 5th Ave, New York, NY'),
  ('350 Fifth Avenue, New York, NY'),
  ('1 Apple Park Way, Cupertino, CA')
) AS t(raw_address);

-- 找出相似度 >= 0.7 的地址对
WITH normalized AS (
  SELECT
    raw_address,
    row_number() OVER () AS rid,
    LOWER(regexp_replace(raw_address, '[^a-zA-Z0-9 ]', '')) AS clean_addr
  FROM addresses
)
SELECT
  a.raw_address,
  b.raw_address,
  round(1.0 - levenshtein(a.clean_addr, b.clean_addr)::FLOAT /
        GREATEST(length(a.clean_addr), length(b.clean_addr)), 2) AS similarity
FROM normalized a
JOIN normalized b ON a.rid < b.rid
WHERE 1.0 - levenshtein(a.clean_addr, b.clean_addr)::FLOAT /
        GREATEST(length(a.clean_addr), length(b.clean_addr)) >= 0.7;
| raw_address | raw_address | similarity |
|---|---|---|
| 1600 Amphitheatre Pkwy… | 1600 amphetamine pkwy… | 0.82 |
| 350 5th Ave, New York, NY | 350 Fifth Avenue, New York, NY | 0.79 |
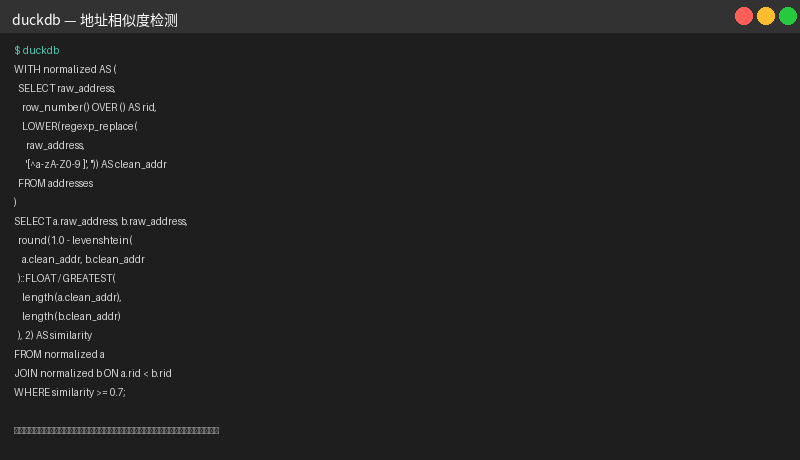
图:基于 Levenshtein 相似度的地址去重,自动识别格式不同但指向同一地点的记录
四、FTS 全文检索扩展
DuckDB 提供 fts 扩展,支持基于 SQLite FTS5 的全文检索能力。
安装与初始化
INSTALL fts;
LOAD fts;
创建索引并搜索
-- 创建模拟产品评论表
CREATE TABLE reviews AS
SELECT * FROM (VALUES
  (1, 'Great laptop, fast and lightweight. Battery lasts all day.'),
  (2, 'Terrible product. Screen cracked after one week of use.'),
  (3, 'The keyboard feels premium, but the trackpad is too small.'),
  (4, 'Excellent value for money. Highly recommend for students.'),
  (5, 'Overpriced and overhyped. Nothing special about this model.')
) AS t(id, comment);

-- 创建 FTS 索引
SELECT create_fts_index('reviews', 'comment', false, false, 'reviews_idx', '', false);

-- 全文搜索(关键词:laptop, battery, keyboard)
SELECT id, comment FROM reviews
WHERE search_fts_index('reviews_idx', 'laptop battery keyboard') > 0
ORDER BY id;
BM25 相关性排序
FTS 扩展内置 BM25 算法,搜索结果按相关度自动排序。rank 值越接近 0,相关性越高。
-- 搜索并查看相关性评分
SELECT
  id,
  comment,
  ROUND(search_fts_index('reviews_idx', 'great value'), 3) AS relevance
FROM reviews
WHERE search_fts_index('reviews_idx', 'great value') > 0;
版本提示:FTS 完整功能(包括虚拟表
fts5和MATCH语法)在 DuckDB v1.6+ 中更为完善。v1.5.x 可通过create_fts_index函数和search_fts_index函数使用核心功能。
五、实战:构建产品推荐引擎
结合以上技术,我们来看一个综合应用——基于文本相似度的产品推荐:
-- 用户历史购买记录
CREATE TABLE purchases AS
SELECT * FROM (VALUES
  (1001, 'Dell XPS 15'),
  (1002, 'HP EliteBook 840'),
  (1003, 'MacBook Pro 14')
) AS t(user_id, product_name);

-- 候选推荐商品
CREATE TABLE candidates AS
SELECT * FROM (VALUES
  ('Dell XPS 17'),
  ('Dell Latitude 5530'),
  ('HP Spectre x360'),
  ('Lenovo ThinkPad T14'),
  ('MacBook Air 15'),
  ('Asus ZenBook 14')
) AS t(product_name);

-- 基于 Levenshtein 距离推荐相似产品
SELECT
  p.user_id,
  p.product_name AS purchased,
  c.product_name AS recommended,
  levenshtein(LOWER(p.product_name), LOWER(c.product_name)) AS similarity_score
FROM purchases p
CROSS JOIN candidates c
WHERE levenshtein(LOWER(p.product_name), LOWER(c.product_name)) <= 8
ORDER BY p.user_id, similarity_score;
| user_id | purchased | recommended | similarity_score |
|---|---|---|---|
| 1001 | Dell XPS 15 | Dell XPS 17 | 1 |
| 1003 | MacBook Pro 14 | MacBook Air 15 | 4 |
总结
| 技术 | 适用场景 | 性能特点 |
|---|---|---|
| LIKE / ILIKE | 简单前缀/后缀/包含匹配 | 极快,适合精确模式 |
REGEXP (~) | 复杂模式匹配与文本替换 | 中等,正则引擎有开销 |
| Levenshtein | 模糊匹配、拼写纠错 | O(n×m),适合小规模数据 |
| FTS (BM25) | 大规模文本搜索、评分排序 | 索引后极快,适合文档库 |
最佳实践建议:
- 先用
LIKE/ILIKE做快速过滤 - 用
REGEXP做结构化数据清洗 - 用
Levenshtein做小量数据的模糊匹配 - 用
FTS扩展处理万级以上的文本搜索需求
更多 DuckDB 实战技巧,请关注 DuckDB Lab(duckdblab.org)